广告
加载中

全球数千零售网点、多品牌多云:一家头部奢侈品厂商的数据底座改造 交付效率提升约70%

龚作仁 2026-10-14 14:39
龚作仁 2026/10/14 14:39

邦小白快读

EN
全文速览

这次DACon大会最直接的干货是:一批中国企业已经把本体技术跑进生产系统,并拿出了可验证的效果数字。比如蚂蚁集团用知识本体把交叉机会识别从3-5天缩到小时级,异动归因准确率超85%;某全球头部奢侈品厂商通过多云数据底座改造,端到端数据交付效率提升约70%,代码生成准确率从30%提升到90%。

1. 想少走弯路,先记住本体落地难的五个原因:没有统一标准、容易做成大而全、实现路径不可逆、口径永远在打架、建完就贬值。这不是理论问题,而是每个企业都会撞上的现实坑。

2. 可复制的方法有三个:一是场景优先的轻量化本体建模,不要一上来就全域铺开;二是双路径混合路由,先让系统跑起来再慢慢长语义资产;三是三级评测加反馈飞轮,用程序、大模型和人工三层兜底保证结果可信。

3. 普通人也能感知的案例是:制造业质量追溯从多人数天变成一人5分钟,良率提升5%;Shopee用图平台识别黑产团伙和异常交易链路;理想汽车让Agent从查数走向销售决策。这些说明本体并不玄,本质是把业务经验变成AI能用的资产。

品牌商最该关注的是:数据底座不再是后台工程,而是直接影响门店运营、用户运营和防伪溯源的竞争力来源。某全球头部奢侈品厂商的多云数据底座案例非常典型,在数据孤岛、合规壁垒和碎片化AI的困境下,通过建设Agent-Ready底座,将端到端数据交付效率提升约70%,代码生成准确率从30%提升到90%,并支撑了门店优化、用户运营、需求预测、防伪溯源等业务场景。

1. 品牌营销和渠道建设方面:基于统一语义层,品牌可以把散落在多云、多品牌系统中的数据打通,形成对用户行为更完整的洞察,支撑更精准的门店选址、陈列优化和全渠道运营。

2. 用户行为观察方面:理想汽车的销售决策案例说明,用本体重新组织对象、关系、指标和业务规则,能让Agent从查数、分析进一步走向销售决策,帮助品牌理解客户购买意图,给出更有效的推荐和跟进策略。

3. 价格竞争和消费趋势方面:Shopee的反欺诈本体建模保护了促销活动免受黑产团伙侵袭,避免异常交易链路造成损失;同时,数据驱动的需求预测能帮助品牌提前安排库存和定价策略。品牌商应意识到,数据治理和知识资产化正在成为品牌基础设施,早期投入能换取长期的运营效率和决策质量。

卖家最值得关注的是跨境电商和零售场景中的风险控制与效率提升机会。Shopee基于图平台的反欺诈本体建模,把账号、设备、交易等实体关系化,识别团伙欺诈和异常交易链路,这对做跨境和促销活动的卖家是直接的风险提示:黑产团伙可能协同伪装,传统表格模型挡不住,需要更智能的关联分析。

1. 增长市场与消费需求层面:高端零售多云数据底座案例显示,门店优化、用户运营、需求预测、防伪溯源都在被AI+数据重塑。卖家如果能接入类似的数据能力,可以更早感知消费需求变化,优化备货和营销节奏。

2. 事件应对和机会提示:天翼支付复盘了本体落地中的返工代价,说明选技术路线要慎重,否则不可逆。但对卖家来说,这意味着相关技术服务商正在成熟,未来可以采购更可靠的数据智能工具,不必自己从零摸索。

3. 可学习点和合作方式:360的渐进式语义层落地方法论给出了“先跑起来、边用边长”的思路。卖家可借鉴这种小步快跑策略,先用轻量级AI问数解决业务问题,再把高频经验沉淀为长期资产。同时,数新智能和奢侈品厂商的合展示出,与专业服务商共建Agent-Ready底座,是传统零售和电商获取新能力的可行路径。

工厂最直接的干货是制造业质量追溯的本体实践:跨CRM、MES、ERP、PLM系统的质量追溯,从多人耗时数天缩短到一人5分钟,良品率提升5%。这说明用本体把业务对象、关系和规则结构化,能让工厂打破系统孤岛,快速定位质量问题源头,减少沟通和返工成本。

1. 产品生产和设计需求方面:工厂在数字化转型中首先要把设备、工序、物料、质量指标等业务对象统一建模,形成可被AI理解和执行的语义层。悦点科技强调“场景优先的轻量化本体建模”,不要追求大而全,否则最先陈旧。工厂应从质量追溯、设备预测维护等高价值场景切入。

2. 数字化和电商启示方面:理想汽车在数据智能上采用本体组织企业数据,让Agent从查数走向销售决策,说明工厂的数据不应只用于报表,要变成支撑决策的知识资产。需要建立“大模型辅助萃取+专家审核”的迭代机制,持续维护本体,避免知识资产折旧。

3. 商业机会方面:本体技术让供应商、生产、质检、售后等环节形成可追溯的语义网络,这不仅能提升内部良率,还能增强对下游客户的响应能力,成为接单和交付的竞争力。工厂应关注多云数据底座和语义层平台,提前布局Agent-Ready的数据能力。

服务商看到的是一张清晰的技术需求地图:企业客户正在从数据平台走向知识系统,急需把业务语义、关系和规则变成AI可消费的资产。多家企业给出了可复用的方案和思考,这正是服务商可参考的解决方案库。

1. 行业趋势方面:本体没有统一标准,Palantir、Snowflake、Databricks、Apache Ossie和Agent Memory五条路线并存。服务商为客户选型时,不能只问有没有图,而要厘清知识如何表示、运行、生产和验证。天翼支付给出了实例层的选型判据:查询形态、时延要求、是否需要状态与回写、变更频率。

2. 客户痛点方面:口径冲突、大而全失败、建完贬值、路径不可逆是最常被提到的坑。蚂蚁的解法是保留差异,用状态机和SQL反向萃取自动构建本体;天翼支付提出概念层与实例层分离;360用双路径混合路由解决冷启动,用置信度分数决定哪些结果可自动入报表,哪些需人工确认。

3. 解决方案方面:Datastrato提出统一元数据、开放语义层、Ontology三层递进;人大提出自进化本体,通过失败归因、候选修改、评测门控和版本回滚形成闭环;数新智能给出多云AI原生平台、企业语义层、沙箱防护和闭环迭代的完整架构。服务商应重点构建可度量、可验收的交付能力,例如五件套模板:本体片段、规则库、案例库、已验证查询、评测集。

平台商能从这次大会看到明确的平台需求和产品方向:企业客户需要的不再是单一的数据目录或语义层,而是能支撑Agent真正“懂业务”的完整基础设施。多个企业案例都提到“Agent-Ready数据底座”这个刚需,这正是平台商的机会窗口。

1. 商业对平台的需求方面:高端零售厂商有数据孤岛、合规壁垒、碎片化AI的痛点,需要多云数智底座加企业专属语义层,还要沙箱安全防护和细粒度权限管控。平台商应把“统一元数据管理”和“本体建模”作为核心能力,而不是简单提供数据连接。

2. 平台最新做法方面:Datastrato正从数据目录演进为AI Context Platform,用统一元数据→开放语义层→Ontology三层递进连接业务概念、数据资产与治理规则。云器科技建议企业从高价值业务域开始,建立知识生产、评估、认证与更新的闭环。360展示了语义资产在使用中自然生长的路径:薄API→厚Skill→本体元数据,最终Skill退化为编排器,知识全由本体层提供。

3. 运营管理和风险规避方面:天翼支付强调概念层与实例层要分开,实例层建映射还是建对象库必须基于四条判据提前决定,否则返工代价极大。平台商在设计产品时,要支持混合方案,并明确边界,让客户避免不可逆的选型错误。同时,大模型生成SQL在生产环境准确率会从85%掉到50%,平台商需要内置三级评测和置信度路由机制,才能让客户敢把AI投入生产。

研究者能从这次大会看到中国产业界在本体落地上的最新动向和真实问题。文章核心观点:本体被讨论很多但跑通的很少,原因是缺乏统一标准、容易大而全、路径不可逆、口径冲突、建完贬值。这为学术研究提供了明确的问题清单。

1. 产业新动向方面:蚂蚁、理想、Shopee、天翼支付、360、数新智能等企业集中展示了生产级本体应用,覆盖金融、汽车、电商、支付、零售、工业软件七大行业。这意味着本体从概念验证进入规模化实证阶段,研究者可基于这些案例提炼可复用的工程模式。

2. 新问题和理论框架方面:天翼支付揭示概念层与实例层的职责划分是核心难点,映射与对象库的取舍不可逆;人大提出自进化数据智能体,用Ontology作为可执行语义层,将业务概念、工具能力和数据模式统一建模,并基于交互轨迹失败归因实现知识修正与评测门控,形成Data-Ontology-Agent协同进化闭环。

3. 政策法规建议和商业模式方面:文章指出“本体在中国落地稀缺”的结构性原因,并强调企业在各自约束下的取舍比标准答案更重要。研究者可关注:如何建立统一但可演进的规范?如何设计持续迭代机制防止知识贬值?如何量化本体投入产出?五条技术路线(Palantir、Snowflake、Databricks、Apache Ossie、Agent Memory)的比较为产业研究提供了清晰的对比样本。

返回默认

声明:快读内容全程由AI生成,请注意甄别信息。如您发现问题,请发送邮件至 run@ebrun.com 。

我是 品牌商 卖家 工厂 服务商 平台商 研究者 帮我再读一遍。

Quick Summary

The most tangible takeaways from DACon: a group of Chinese companies have already moved ontology technology into production systems, with verifiable results. Ant Group reduced cross-opportunity identification from 3–5 days to hours using a knowledge ontology, with anomaly attribution accuracy above 85%. A leading global luxury goods manufacturer revamped its multi-cloud data foundation, improving end-to-end data delivery efficiency by roughly 70%, and raising code generation accuracy from 30% to 90%.

1. To avoid pitfalls, start by remembering five reasons ontology adoption fails: no unified standards, over-engineering into big-bang projects, irreversible implementation paths, conflicting data definitions, and knowledge that depreciates after creation. These are not theoretical issues—they are real obstacles every enterprise will encounter.

2. Three replicable methods stand out: first, scenario-first lightweight ontology modeling rather than attempting full-scale deployment from day one; second, dual-path hybrid routing that gets systems running before gradually accumulating semantic assets; third, a three-tier evaluation and feedback flywheel combining programmatic checks, LLM validation, and human review to ensure trustworthy results.

3. Cases visible to the general public: in manufacturing, quality traceability dropped from several people taking days to one person taking five minutes, while yield improved by 5%. Shopee used a graph platform to identify fraud rings and abnormal transaction chains. Li Auto enabled agents to move from data querying to sales decision-making. These examples show ontology is not esoteric—it is essentially converting business experience into assets AI can use.

For brand owners, the key insight is that the data foundation is no longer just back-end engineering—it directly shapes competitiveness in store operations, user engagement, and anti-counterfeiting traceability. The multi-cloud data foundation case of a leading global luxury goods manufacturer is highly illustrative: amid data silos, compliance barriers, and fragmented AI, they built an Agent-Ready foundation that lifted end-to-end data delivery efficiency by about 70%, raised code generation accuracy from 30% to 90%, and supported scenarios including store optimization, user operations, demand forecasting, and anti-counterfeiting traceability.

1. In brand marketing and channel building: with a unified semantic layer, brands can break down data scattered across multi-cloud and multi-brand systems, forming more complete insights into user behavior, enabling more precise store site selection, layout optimization, and omnichannel operations.

2. In user behavior observation: Li Auto's sales decision case shows that reorganizing objects, relationships, metrics, and business rules with ontology allows agents to progress from data lookup and analysis to sales decisions, helping brands understand customer purchase intent and deliver more effective recommendations and follow-up strategies.

3. In price competition and consumption trends: Shopee's anti-fraud ontology modeling protects promotional campaigns from fraud rings, avoiding losses from abnormal transaction chains. Meanwhile, data-driven demand forecasting helps brands plan inventory and pricing in advance. Brands should recognize that data governance and knowledge assetization are becoming infrastructure—early investment pays off in long-term operational efficiency and decision quality.

For sellers, the most relevant opportunities lie in risk control and efficiency gains in cross-border e-commerce and retail. Shopee's fraud-fighting ontology modeling on a graph platform turns accounts, devices, and transactions into relational entities to identify organized fraud and abnormal transaction chains. This is a direct warning for sellers running cross-border and promotional campaigns: fraud rings can coordinate in disguise, traditional tabular models cannot stop them, and smarter relational analysis is required.

1. In growth markets and consumer demand: the luxury retail multi-cloud data foundation case shows that store optimization, user operations, demand forecasting, and anti-counterfeiting traceability are all being reshaped by AI and data. If sellers can tap into similar data capabilities, they can sense shifts in consumer demand earlier and optimize stocking and marketing cadence.

2. In incident response and opportunity signals: China Telecom Bestpay's review of rework costs in ontology implementation shows that choosing a technical path carefully matters, because some paths are irreversible. For sellers, this signals that relevant technology service providers are maturing; in the future they can buy more reliable data intelligence tools rather than building everything from scratch.

3. In learning points and collaboration approaches: 360's progressive semantic layer methodology offers a “run first, grow with use” mindset. Sellers can adopt this small-step-fast-iteration strategy: use lightweight AI question-answering to solve business problems first, then consolidate recurring experience into long-term assets. Meanwhile, the partnership between Shuxin New Intelligence and the luxury manufacturer demonstrates that building an Agent-Ready foundation with professional service providers is a viable path for traditional retail and e-commerce to acquire new capabilities.

The most direct takeaway for factories is the ontology practice in manufacturing quality traceability: traceability across CRM, MES, ERP, and PLM systems was shortened from multiple people spending days to one person taking five minutes, while the yield rate improved by 5%. This shows that structuring business objects, relationships, and rules with ontology can break system silos, quickly locate quality issues at their source, and reduce communication and rework costs.

1. In product production and design needs: factories starting digital transformation should first build a unified model of business objects such as equipment, processes, materials, and quality metrics, forming a semantic layer that AI can understand and execute. YueDian Technology emphasized “scenario-first lightweight ontology modeling”—do not pursue comprehensiveness, or it will become obsolete first. Factories should enter from high-value scenarios like quality traceability and predictive equipment maintenance.

2. In digitalization and e-commerce insights: Li Auto uses ontology to organize enterprise data, enabling agents to advance from data lookup to sales decisions. This shows factory data should not be used only for reports; it must become knowledge assets that support decision-making. A continuous iteration mechanism of “LLM-assisted extraction plus expert review” is needed to maintain the ontology and prevent knowledge depreciation.

3. In business opportunities: ontology technology creates a traceable semantic network across suppliers, production, quality inspection, and after-sales. This improves internal yield and strengthens responsiveness to downstream customers, becoming a competitive advantage in winning orders and delivering. Factories should pay attention to multi-cloud data foundations and semantic layer platforms, and position themselves early with Agent-Ready data capabilities.

Service providers can see a clear technology demand map: enterprise clients are moving from data platforms to knowledge systems, urgently needing to turn business semantics, relationships, and rules into AI-consumable assets. Multiple companies shared reusable approaches and reflections, forming a solution library for service providers.

1. In industry trends: there is no unified ontology standard; Palantir, Snowflake, Databricks, Apache Ossie, and Agent Memory represent five co-existing paths. When helping clients select technology, service providers cannot just ask whether a graph exists—they must clarify how knowledge is represented, run, produced, and validated. China Telecom Bestpay offered selection criteria at the instance layer: query patterns, latency requirements, whether state and write-back are needed, and change frequency.

2. In client pain points: conflicting definitions, the big-bang failure, depreciation after creation, and irreversible paths are the most frequently cited pitfalls. Ant Group's solution preserves differences and uses state machines plus reverse extraction to auto-build the ontology. China Telecom Bestpay proposed separating the concept layer from the instance layer. 360 uses dual-path hybrid routing to solve cold-start problems, with confidence scores determining which results can be automatically written to reports and which need human confirmation.

3. In solutions: Datastrato proposed a three-tier progression from unified metadata to an open semantic layer to Ontology. Renmin University proposed a self-evolving ontology, forming a closed loop through failure attribution, candidate changes, evaluation gates, and version rollback. Shuxin New Intelligence delivered a complete architecture with a multi-cloud AI-native platform, enterprise semantic layer, sandbox protection, and iterative closed-loop. Service providers should focus on building measurable, acceptance-ready delivery capabilities, for example a five-part template: ontology snippets, rule bases, case libraries, validated queries, and evaluation sets.

Platform providers can identify clear platform demands and product directions from this conference: enterprise clients no longer need just a data catalog or semantic layer—they need complete infrastructure that enables agents to genuinely “understand the business.” Multiple enterprise cases mention the “Agent-Ready data foundation” as a critical need, which is exactly the opportunity window for platform providers.

1. In commercial platform requirements: high-end retail manufacturers face pain points such as data silos, compliance barriers, and fragmented AI. They need a multi-cloud data intelligence foundation plus an enterprise-specific semantic layer, along with sandbox security and fine-grained permission control. Platform providers should make “unified metadata management” and “ontology modeling” core capabilities, not just simple data connectivity.

2. In the latest platform approaches: Datastrato is evolving from a data catalog to an AI Context Platform, using a three-tier progression of unified metadata → open semantic layer → Ontology to connect business concepts, data assets, and governance rules. Yunqi Technology suggests enterprises start from high-value business domains and build a closed loop of knowledge production, evaluation, certification, and renewal. 360 demonstrated the path of semantic assets growing naturally through use: thin API → thick Skill → ontology metadata, eventually with Skills degrading into orchestrators while knowledge is fully provided by the ontology layer.

3. In operations management and risk avoidance: China Telecom Bestpay emphasized that the concept layer and instance layer must be separated. For the instance layer, whether to build mappings or object libraries must be decided in advance based on four criteria; otherwise rework costs are enormous. Platform providers should design products that support hybrid approaches and clearly define boundaries to help clients avoid irreversible selection errors. Additionally, LLM-generated SQL accuracy in production can drop from 85% to 50%. Platform providers must build in three-tier evaluation and confidence-based routing so clients feel safe putting AI into production.

Researchers can observe the latest industry trends and real problems in ontology adoption in China from this conference. Core argument: ontology is widely discussed but rarely successfully deployed, due to lack of unified standards, a tendency toward big-bang projects, irreversible paths, conflicting definitions, and post-build depreciation. This provides a clear problem list for academic research.

1. In new industry trends: Ant Group, Li Auto, Shopee, China Telecom Bestpay, 360, and Shuxin New Intelligence collectively showcased production-grade ontology applications across seven industries: finance, automotive, e-commerce, payments, retail, and industrial software. This means ontology is moving from concept validation to large-scale empirical validation. Researchers can distill reusable engineering patterns from these cases.

2. In new problems and theoretical frameworks: China Telecom Bestpay revealed that the division of responsibilities between the concept layer and instance layer is a core difficulty, and the choice between mappings and object libraries is irreversible. Renmin University proposed a self-evolving data intelligent agent that uses Ontology as an executable semantic layer, unifying business concepts, tool capabilities, and data models, and forming a Data-Ontology-Agent co-evolution closed loop through failure attribution from interaction traces, knowledge correction, and evaluation gates.

3. In policy and business model implications: the article identifies structural reasons for the scarcity of ontology deployment in China, and stresses that enterprises’ trade-offs under their own constraints matter more than standard answers. Researchers can focus on: how to establish unified yet evolvable specifications? How to design continuous iteration mechanisms to prevent knowledge depreciation? How to quantify ontology ROI? The comparison of five technical routes—Palantir, Snowflake, Databricks, Apache Ossie, and Agent Memory—offers a clear comparative sample for industry research.

Disclaimer: The "Quick Summary" content is entirely generated by AI. Please exercise discretion when interpreting the information. For issues or corrections, please email run@ebrun.com .

I am a Brand Seller Factory Service Provider Marketplace Seller Researcher Read it again.

本体(Ontology)这个词,在中国技术圈被讨论了至少十年。但讨论和落地之间,隔着一条很宽的沟。一位在金融风控一线做本体的讲师,在提交议题时写了这么一句话——“本体在企业里被讨论得很多,真正跑通的很少。”

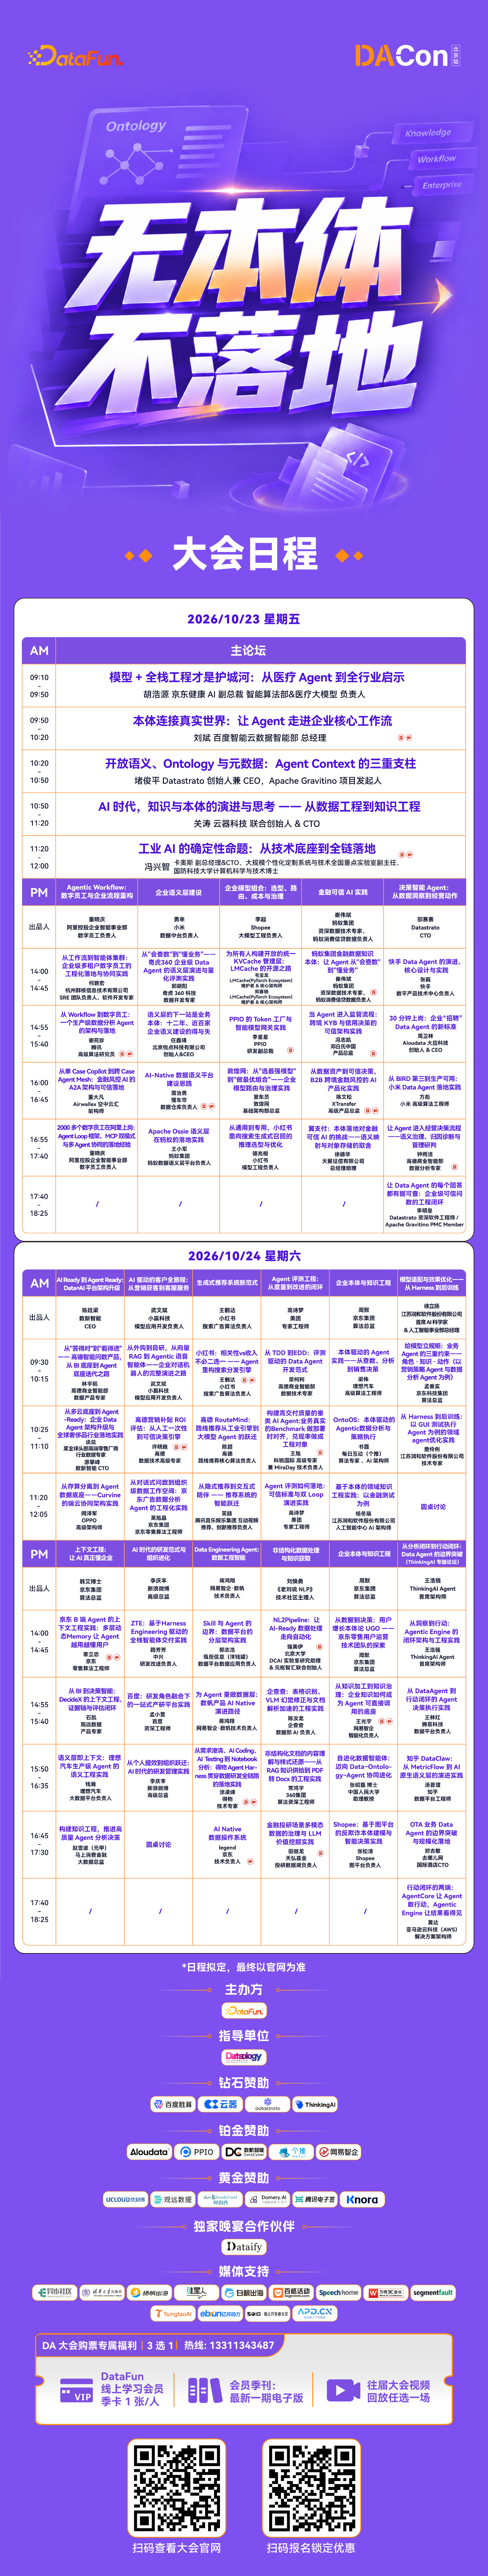
所以,真正把本体跑进生产系统的中国企业,一只手数得过来。10月 23-24日,DACon 2026北京站,这批企业第一次集中出现,并且把账本摊开了。

为什么少?

没有统一标准。Palantir、Snowflake、Databricks、Apache Ossie、Agent Memory,五条路线各走各的,差异不在“有没有图”,而在知识怎么表示、怎么运行、怎么生产、怎么验证。企业面对的不是“好不好”,是“跟谁”。

容易做成“大而全”。全域一次性铺开的本体,往往是最先陈旧的那一个。业务一变,它就臃肿、失效、贬值。

实现路径不可逆。本体到底是一层“翻译”还是一份“数据”?只建映射上线快但多跳跑不动,真建对象库查得快但要啃同步、一致性、成本、“谁是真值”一堆硬骨头。选错了,只能推倒重建。

口径永远在打架。各业务线对“活跃用户”各说各话,强行统一会扭曲业务理解,不统一Agent又不知道该听谁的。

建完就贬值。缺少持续迭代机制,知识资产从交付那天起开始折旧。

10月23-24日,DACon 2026北京站,这批企业第一次集中出现,并且把账本摊开了。

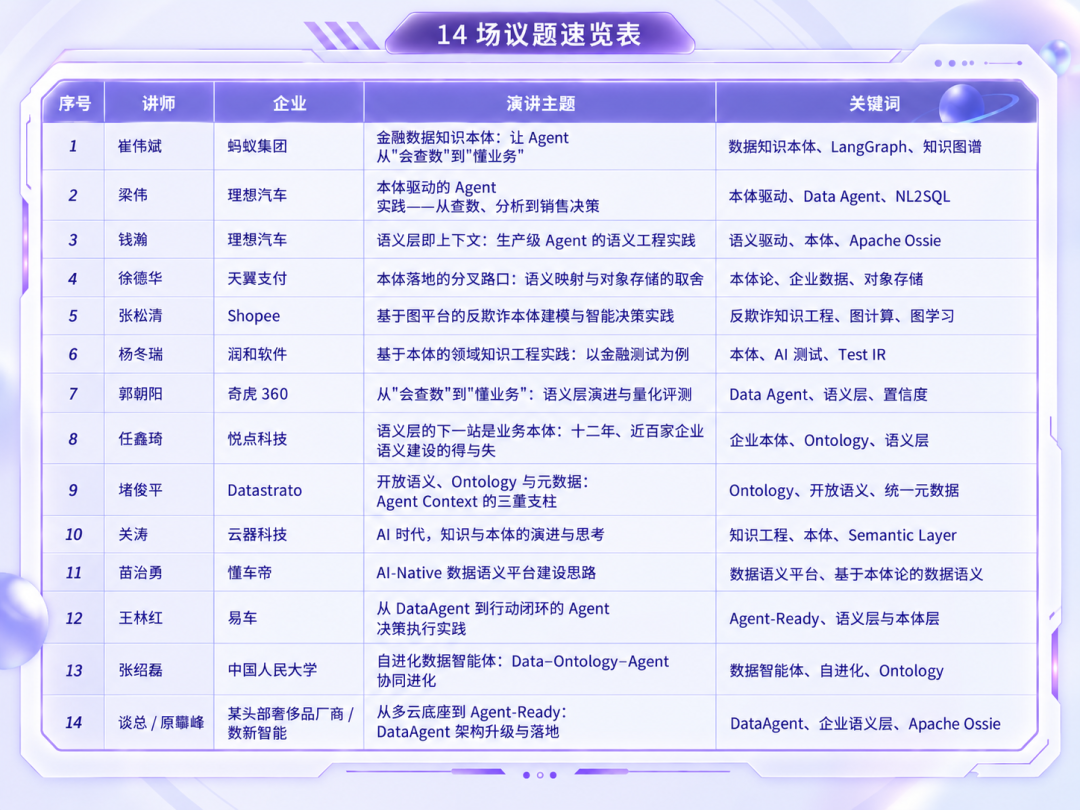
蚂蚁集团、理想汽车、Shopee、天翼支付、奇虎360、懂车帝、易车、润和软件、悦点科技、云器科技、Datastrato、数新智能,以及中国人民大学——14场演讲,覆盖金融、汽车、跨境电商、支付、内容、零售、工业软件七个行业。

01

本体已经跑进生产系统的企业

这7 场不是方法论推演,是已经在业务里跑起来、并且拿得出数字的实证。

01|蚂蚁集团:金融数据知识本体,让Agent从“会查数”到“懂业务”

讲师:崔伟斌 · 蚂蚁集团 · 资深数据技术专家、蚂蚁消费信贷数据负责人

演讲主题:蚂蚁集团金融数据知识本体:让Agent从“会查数”到“懂业务”

演讲介绍:蚂蚁的选择是:放弃“按表取数”的传统范式,用数据知识本体打通多源业务语义,把字段和指标翻译成“用户”“产品”“行为”这类业务对象,让系统理解数据到底在“说什么”。

最典型的问题是各业务线对“活跃用户”各说各话。蚂蚁的做法不是强行统一——而是让本体保留差异,Agent按需取用。底层用LangGraph六节点状态机(InputParser→ Comprehender→ EntityResolver→ Reconciler→ Synthesizer→ Verifier)自动化完成本体合成与校验;同时用SQL Understander从历史任务代码里反向萃取字段语义和表间关联,形成“代码即标注”的自动生成管线。

服务层用互索引架构,同步检索三类知识:KG_cs(业务视角,如花呗“活跃用户”的定义规则)、KG_fr(实体关系图,如“用户A-持有-借呗额度5万”)、RC(原始文档证据),三层结果融合去重后打包成KnowledgePackage。

效果:交叉机会识别从3-5天缩到小时级,异动归因准确率超85%,已支撑多条营销策略落地。

“本体不是字典,是让系统‘懂业务’的教材。”

演讲提纲:

1. 方案选型:为什么放弃“按表取数”,改走数据知识本体

2. 底层:LangGraph六节点状态机,实现表结构全量感知、实体识别、跨表矛盾消融、本体合成与校验

3.SQL Understander(sqlglot+ 正则):从历史任务代码反向萃取字段语义与表间关联

4.Reconciler:跨表同名字段的7 层级成本递进消融(全自动合并 → 人工确认),核心原则是冲突标记但不强制合并

5.Verifier:Pydantic+ 业务规则 + 深坑检测三重校验,不通过触发L4重试或降级warning

6. 服务层:KG_cs/ KG_fr/ RC三层协同检索的互索引架构

7. 成效:覆盖数千张表,交叉机会识别小时级,异动根因分析准确率85%+

听众收益:

· 掌握一套可复用的“海量表自动化本体构建”方法论

· 理解“分层联合召回”架构如何提升业务分析效率

· 获得“多业务线口径冲突”在金融场景下的实战经验

02|理想汽车:本体驱动的Agent,从查数、分析走到销售决策

讲师:梁伟 · 理想汽车 · 企业智能-算法研发 · 高级算法工程师、数据智能部门负责人

演讲主题:本体驱动的Agent实践——从查数、分析到销售决策

演讲介绍:理想汽车曾通过后训练把自然语言问数的业务准确率做到接近100%。但随之而来的问题更棘手:知识准备和训练周期很长,扩展到新领域困难,业务口径一变就难以维护。

为解决这个问题,团队开始用本体重新组织企业数据,让对象、关系、指标和业务规则变成Agent可理解、可查询的语义结构。

这场演讲会复盘从NL2SQL、MCP、Skill到内置Agent的四次演进与取舍,并结合销售决策的真实实践,讲清本体如何支撑Agent从查数、分析,进一步走向业务决策。

演讲提纲:

1. 智能问数做得很准之后,我们遇到了什么:NL2SQL与后训练方案在扩展和维护上的局限

2. 企业数据为什么需要按Agent的理解方式重新组织:业务语义与底层数据结构之间的距离

3. 如何设计面向Agent的本体:对象、属性、关系、指标、业务规则与语义查询机制

4. 从MCP、Skill到内置Agent的三次迭代:灵活性、稳定性和接入成本之间的取舍

5. 从查数走向决策:业务事实层、销售认知层、场景执行层的三层设计

6. 本体建设的边界与下一步:知识治理、持续优化中尚未完全解决的问题

听众收益:

· 理解NL2SQL在单领域取得高准确率后,仍然会遇到的扩展、维护和知识更新问题

· 了解如何通过对象、关系、指标和业务规则组织本体,降低Agent理解和使用企业数据的难度

· 获得一次基于实际业务场景的本体建模与应用经验,看本体如何支撑从查数分析走向业务决策

03|理想汽车:语义层即上下文,生产级Agent的语义工程

讲师:钱瀚 · 理想汽车 · 大数据平台负责人

演讲主题:语义层即上下文:理想汽车生产级Agent的语义工程实践

演讲介绍:生产级Agent的真正瓶颈不在模型能力,而在上下文质量——Agent拿到的是散落在Prompt、工具、日志里的碎片化信息,还是经过语义治理、可理解、可追溯的结构化上下文,决定了它能不能在生产环境稳定交付。

以Spark/Flink故障诊断为例,理想汽车把散落在Prompt与工具中的知识,拆分为本体、OSI、Playbook和通用执行层四层,为Agent构建高质量语义上下文。Agent据此跨日志、指标、数仓取证,形成有证据的根因判断,并把诊断缺口沉淀为可版本化、可校验、可回归的语义资产。

钱瀚拥有十余年分布式大数据与AI基础设施建设经验,先后任职搜狗、百度、京东、字节跳动,现主导理想汽车大数据云原生、实时数据湖、元数据与语义层技术落地,服务百万级车辆大数据场景,承载万亿级车辆信号处理。

演讲提纲:

1. 生产级Agent的上下文挑战:为什么散落知识是最大瓶颈

2. 语义层即上下文工程:本体、OSI、Playbook的职责边界与协作

3. 理想汽车落地实践:从故障诊断到有证据的根因判断

4. 关键取舍与演进:从单点场景到生产级Agent平台

听众收益:

· 掌握一套将专家经验转化为可治理语义资产、为Agent提供高质量上下文的方法

· 理解本体、查询语义、Playbook和工具层在上下文构建中的职责边界

· 学会构建带证据、置信度和答案边界的Agent输出,理解语义约束如何提升上下文质量

· 获得一条从单点场景逐步演进到生产级Agent平台的实践路径

04|天翼支付:本体落地的分叉路口——语义映射与对象存储的取舍

讲师:徐德华 · 天翼支付科技有限公司(天翼电子商务有限公司)· 风险管理部总监、模型团队负责人、总经理助理

演讲主题:本体落地的分叉路口:语义映射与对象存储的取舍与实践

演讲介绍:这是全场最直接的一本体落地复盘。

天翼支付在建设过程中反复撞上同一个问题:本体到底是一层“翻译”,还是一份“数据”?

· 只建映射,本体就是一层元数据,查询时翻译成面向数仓的SQL,数据不搬家、上线快、无冗余;但多跳穿透跑不动,口径受底层表结构牵制,对象的状态和执行结果没有地方落。

· 真建一个对象库,把实例、属性、关系物化存下来,查得快、能承载状态、支持决策闭环;但要面对实时同步、增量一致性、存储成本和“谁是真值”这一堆问题。

这个选择基本不可逆。

而它的上游还有一个更容易被跳过的问题:概念口径和真实业务数据,本来就不该混在一层做。

这场演讲会完整交代这两个问题上的判断依据、混合方案的边界划法,以及为此付出返工代价的几个决策,同时给出本体如何为智能体供数、跨域如何复用、项目以什么标准验收的具体做法。

演讲提纲:

1. 业务背景:本体已经建成,智能体依然用不起来——三个现实瓶颈(缺少企业运行现实的表达、组织经验无法继承、单场景建设形成语义孤岛)

2. 方案选型:概念口径与业务数据为什么必须分两层做——概念层负责对象/属性/关系/口径/规则,实例层负责亿级实例、状态变化、历史链路与结果回写

3. 落地挑战:实例层是建映射还是建实例库——四条选型判据:查询形态、时延要求、是否需要状态与回写、变更频率

4. 解决思路:混合方案与一致性保障——核心对象物化、长尾保留映射,边界必须写死而不是临场判断

5. 面向智能体供数:最小必要上下文、受治理访问接口、回退条件与风险计量

6. 跨域复用与验收标准:业务域资产交付五件套(本体片段、规则库、案例库、已验证查询、评测集)

听众收益:

· 认知刷新:本体落地的真正难点不在建模方法,而在概念层与实例层的职责划分,以及实例层实现路径的不可逆选择

· 方法可复用:语义映射与对象存储的正面对比、四条选型判据、混合方案的边界划法,可直接用于自身架构决策

· 实践指南:面向智能体供数的具体设计与跨域复用规则,以及一套让本体项目可度量、可验收的交付模板与踩坑清单

05|Shopee:基于图平台的反欺诈本体建模与智能决策

讲师:张松清 ·Shopee· Data Infra· 图平台负责人

演讲主题:Shopee:基于图平台的反欺诈本体建模与智能决策实践

演讲介绍:面对电商促销和信贷中账号、设备、交易等多实体协同伪装,传统表格模型很难识别团伙欺诈。Shopee图平台把对象、关系与风险规则进行本体化建模,形成动态反欺诈知识网络:图数据库支撑实时关联查询,图计算发现社区和关键节点,图学习模型预测风险。

两个真实场景会完整展开:Monee Credit用户关系图与信贷风控(贷前贷中识别效果提升明显,通过图数据库对线上借贷申请做实时资质审批),以及Shopee订单促销知识图谱与欺诈检测(结合图计算和RGAT等图学习模型识别黑产团伙与异常交易链路)。

张松清2018年起参与蚂蚁集团自研图存储系统从0 到1 建设,发表图数据专利2 篇,后参与阿里搜索索引统一存储层研发,现负责Shopee图平台开发。

演讲提纲:

1. 业务背景:反欺诈为什么需要知识工程——传统表格模型难以识别团伙型、跨场景欺诈

2. 方案选型:一站式图平台与知识构建——图数据库 + 图计算 + 图学习的协同

3. 实践一:Monee Credit用户关系图与信贷风控,贷前贷中效果提升与实时资质审批

4. 实践二:Shopee订单促销知识图谱与欺诈检测,RGAT识别黑产团伙与异常交易链路

5. 落地挑战与工程化:大规模异构关系、实时更新、特征供给、训练效率;特征预取与批处理优化

6. 未来规划:演进为可解释、可推演的动态反欺诈本体;探索GraphRAG与 Agent

听众收益:

· 了解面向企业的知识工程方法:如何将业务对象、关系和风险规则本体化建模,构建可实时演化的知识网络

· 掌握图数据库、图计算和图学习的选型边界与协同方式

· 获得电商促销和金融信贷风控实践经验,形成数据、规则与模型的闭环

06|润和软件:基于本体的领域知识工程——以金融测试为例

讲师:杨冬瑞 · 江苏润和软件股份有限公司 · 人工智能中心 ·AI架构师

演讲主题:基于本体的领域知识工程实践:以金融测试为例

演讲介绍:金融测试正从经验驱动转向AI辅助,但大模型直接生成仍面临三个硬伤:方法难复用、结果难追溯、质量难评估。

润和软件的解法是测试本体 +Test IR:结合业务本体沉淀测试方法论,以Test IR打通需求、大纲和案例;Agent负责语义理解与方法选择,工具负责数据计算、案例装配和校验,形成“需求解析 →IR→ 方法应用 → 案例生成”的可追溯链路。

这场演讲还会正面比较四条路线:直接用大模型(快但黑盒)、固定工作流与提示词(适合单场景但强耦合)、RAG知识检索(能补知识但表达不了方法适用条件和输出约束)、本体与Test IR(结构化、适合长期治理)。

杨冬瑞为东南大学博士,曾就职于华为2012实验室,主导众核系统性能分析平台建设、AI辅助模型驱动开发工具开发。

演讲提纲:

1. 业务背景:为什么需要重新设计AI测试平台——需求/大纲/案例缺少统一表达,优秀方法难沉淀,Dify/提示词/Skill/脚本资产分散

2. 方案选型:为什么选择“本体 +Test IR+ Agent+ 工具”——四条路线对比

3. 总体架构:平台如何运转

4. 落地挑战:测试场景本体的分层与构建、本体的管理与演进、Test IR设计与应用、测试方法论的构建与应用

5. 展望与总结

听众收益:

· 理解业务本体、测试本体和Test IR的职责边界,以及三者如何共同支撑AI测试

· 获得一条可渐进实施的建设路线:从现有提示词、Skill和脚本出发,逐步演进为可查询、可治理的测试平台体系

07|奇虎360:从“会查数”到“懂业务”,语义层的渐进式演进与量化评测

讲师:郭朝阳 · 北京奇虎360· 数据开发 · 湖仓Data Agent化演进技术负责人

演讲主题:从“会查数”到“懂业务”——奇虎360企业级Data Agent的语义层演进与量化评测实践

演讲介绍:360在云数仓架构之上搭了一个“聊着天就把数据查了”的AI应用。但做着做着发现,想让它从“会查数”变成“懂业务”,中间隔着一座大山——语义层。

大模型写SQL,学术数据集上能跑到85%,一进真实数仓就现原形:几百张表、上万个字段、口径靠口口相传,准确率断崖式下跌,而且错了你都不知道它错在哪。

更麻烦的是,业务不可能等你花半年把语义层建好再上线。360的做法是“半成品冷启动,边跑边长”:

· 双路径混合路由:语义完整的走确定性编译引擎(AST主路径),只有表和文档的走RAG降级;每条结果带置信度分数——0.95以上自动入报表,0.65以下系统主动提示“这条我不太确定,建议人工确认”

· 薄API→ 厚Skill→ 本体元数据:高频使用的经验反向沉淀为语义资产,最终Skill退化为纯编排器,知识全由本体层提供

· 三级评测 + 反馈飞轮:L1程序自动比对结果集 →L2 LLM Judge语义判断 →L3人工兜底,用户点赞经防污染过滤后自动采样为回归测试集

目前这套方案已支撑内部大数据集群运维、S3、PoleFS存储运维的指标分析与归因,Ops机房运维、文库搜索、会员中台等跨部门业务也已接入。

演讲提纲:

1. 范式转变:从“模型写SQL”到“引擎写SQL”——Spider 85% → 真实数仓50%,差距来自哪里

2. 双路径混合路由:语义层不完善时的冷启动方案——AST主路径 +Fallback RAG降级 +PreMatch置信度路由

3. 置信度的真正价值:不只是“准不准”,而是决定哪些场景敢投入生产

4.Skill体系:薄API→ 厚Skill→ 本体元数据,与Snowflake Cortex Agent的层面对齐

5. 量化评测:学术基准为什么不够,三级评测架构与数据飞轮

听众收益:

· 一套可迁移的渐进式语义层落地方法论:双路径路由让系统先跑起来,RAG+ 置信度引导让语义资产在使用中自然生长

· 理解NL2SQL学术与生产的鸿沟,以及如何搭建面向业务口径的生产级评测体系

· 掌握Skill到本体层的演进路径与设计取舍

· 可复用的三级评测架构:L1程序 →L2 LLM→ L3人工 + 反馈数据飞轮 + 回归测试

02

本体与语义层:工程方法论与选型地图

这5 场回答一个问题:本体该怎么建、跟谁走、投入产出的边界在哪。

08|悦点科技:语义层的下一站是业务本体,十二年、近百家企业语义建设的得与失

讲师:任鑫琦 · 北京悦点科技有限公司 · 创始人兼CEO

演讲主题:语义层之上:让企业隐性经验成为AI可执行的资产——十二年、近百家企业的本体落地实践与教训

演讲介绍:你的语义层,是给人建的、给BI建的,还是给AI建的?

很多企业已经建起了数据平台和语义层,也上线了大模型应用,但项目往往停在同一个地方:AI能查数、能答题,却进不了核心业务流程。原因在于业务概念、指标口径、业务约束以及专家的判断依据,大多以隐性经验的形式散落在文档和人的脑子里,从未真正被交付给AI。

任鑫琦的核心观点是:领域本体不是数仓语义层的另一种叫法,而是一层独立于大模型的企业业务世界模型——它组织的是业务对象、关系、规则与可执行动作。

他从北大人工智能实验室开始做知识工程(方向包括Ontology、知识表达与推理),2014年起在明略数据从零孵化企业知识图谱产品SCOPA,到现在悦点Knora AI平台,已经第十二年,服务近百家大型企业(制造、汽车、能源等)。这次他把建设体系、落地关键、成功与失败都摊开讲。

演讲提纲:

1. 开场:十二年、近百家企业,和一个5‰ 的故事——我们在企业里究竟看到了什么

2. 语义层与业务本体:差在哪、能不能演进——本体作为独立于大模型的企业业务世界模型

3. 我们踩过的坑:术语与指标口径不一致;“大而全”的本体最先陈旧;业务、算法、数据三方认知难对齐

4. 方法论:场景优先的轻量化本体建模,大模型辅助知识萃取 + 专家审核的闭环迭代机制

5. 本体如何约束大模型:在RAG与 Agent全链路做概念校验与生成约束,统一口径、降低幻觉

6. 案例拆解:制造业质量追溯——跨CRM/MES/ERP/PLM的追溯从多人数天到一人5 分钟,良率提升5%

7. 总结:大模型是表达与交互层,本体承载企业独有的业务知识,共同构成企业长期AI资产

听众收益:

· 拿到“语义层 → 业务本体”的演进判断:现有指标平台与语义层哪些可以复用、哪些需要重建,避免推倒重来

· 理解为什么仅靠向量检索与RAG难以支撑复杂业务推理,以及本体在LLM全链路中统一口径、约束生成的具体作用机制

· 获得一套可复制的隐性经验资产化路径:把一次性项目成果沉淀为企业长期可复用、可治理、可迭代的知识资产

· 获得来自近百家企业的横截面经验:本体 +Agent在工业场景落地的常见失败模式、实施难点与规避策略

09|Datastrato:开放语义、Ontology与元数据,Agent Context的三重支柱

讲师:堵俊平 ·Datastrato· 创始人兼CEO,Apache Gravitino项目发起人

演讲主题:开放语义、Ontology与元数据:Agent Context的三重支柱

演讲介绍:当Agent从回答问题走向推理、决策与执行,数据的可访问性已不足以支撑可靠的智能。Agent不仅需要知道“数据在哪里”,还需要理解“数据意味着什么”“业务实体如何关联”,以及“行动受哪些规则约束”。

堵俊平给出的框架是三层递进:

· 统一元数据——基于Apache Gravitino的跨云、跨引擎、多模态数据统一元数据管理,为数据资产提供一致描述与访问接口

· 开放语义层——指标、维度、业务定义标准化,消除“一个指标多个口径”

·Ontology(本体)——建模业务实体、关系与规则,使Agent能把自然语言中的业务意图精确映射到真实数据

他还会正面比较两条上下文建设路径:自上而下(应用任务驱动,快但容易形成上下文孤岛)与自下而上(元数据治理驱动,底座扎实但推导不出业务含义),并给出“业务场景牵引建模 + 统一元数据连接 + 反馈迭代”这一更可持续的混合路径。

堵俊平原任LF AI&Data基金会董事主席,曾任腾讯开源负责人兼大数据研发总监、Cloudera Hadoop团队负责人。

演讲提纲:

1. 开篇:从数据连接到上下文构建的演进——Agent需要的三件事

2.Agent Context的三重支柱:统一元数据 → 开放语义层 →Ontology逐层递进

3. 两种策略比较:自上而下vs自下而上,各自的适用场景与局限

4. 更可持续的混合路径:业务场景牵引建模,以统一元数据连接业务概念、数据资产与治理规则,通过业务校验和Agent反馈持续迭代

5. 产品化实践:从数据目录到AI Context Platform(Datastrato 2.0/ Gravitino 2.0企业版)

听众收益:

· 建立对Agent上下文基础设施的完整认知框架:理解三层递进关系如何支撑Agent从“找数据”到“懂业务”再到“守规则”

· 掌握两条建设路径的适用场景与局限,获得更可持续的混合策略方法论

· 了解数据目录向AI Context Platform演进的产品化方向,获取可参考的架构设计与技术选型思路

· 获得治理视角的实践参考:如何在明确治理边界内让Agent把业务意图映射到真实数据

10|云器科技:本体没有统一标准,五条路线企业该跟谁?

讲师:关涛 · 云器科技 · 联合创始人 &CTO

演讲主题:AI时代,知识与本体的演进与思考——从数据工程到知识工程

演讲介绍:AI时代对企业来说,模型与Harness能力决定效果的下限,企业知识系统决定AI产生业务价值的上限。

为什么企业已经建设了数据平台、RAG和知识图谱,AI仍然经常答不准、说不清、做不了?问题往往不只在模型和Agent Harness,而在于企业缺少一套能够表达业务语义、关系、规则和上下文,并连接真实行动的知识系统。

本体是组织企业知识的重要方式,但本体当前没有统一标准。Palantir、Snowflake、Databricks、Apache Ossie与 Agent Memory实际采用了五种不同路线。它们真正的差异不是“有没有图”,而是知识如何表示、运行、生产和验证。

这场演讲从DIKW出发,拆解知识与本体的演进,比较五类主流技术路线,并给出企业从数据工程走向知识工程的落地路径。

关涛有17年分布式系统和大数据平台开发经验。2006年在微软亚洲研究院构建微软第一代分布式KV系统(7000台规模)和Bing搜索分布式存储后台(4万台规模);2016年回国加入阿里云,任计算平台事业部研究员、阿里巴巴通用计算平台负责人(飞天MaxCompute,10万+规模);2021年创立云器科技。2018浙江省科技进步一等奖,2021 USENIX ATC best paper award。

演讲提纲:

1.AI时代,为什么有了数据还不够

2. 知识、本体、Semantic Layer与知识图谱的关系

3. 本体当前没有统一标准:五类主流路线如何选择

4. 企业知识建设的起点:内核、外围与开放接口

5. 持续知识工程的参考架构和案例:生产、评估、认证与更新

听众收益:

· 一张概念地图:厘清数据、知识、本体、Semantic Layer与知识图谱

· 一张选型地图:看懂五类主流方案的差异、边界与适用场景

· 一条落地路线:从高价值业务域开始,建立可持续演进的企业知识闭环

11|懂车帝:AI-Native数据语义平台,本体是强约束知识层

讲师:苗治勇 · 懂车帝 · 数据仓库负责人

演讲主题:AI-Native数据语义平台建设思路

演讲介绍:AI问数正在成为数据消费的基础能力,但大模型直接回答业务数据问题时,容易出现幻觉、不稳定、不置信。尤其在Text2SQL场景,单纯依赖模型训练知识或文本召回,很难保证结果准确一致。

语义层的价值,是在大模型和底层数据资产之间增加一层强约束知识。它把指标、维度、实体、业务过程、物理实现、SQL规则结构化管理起来,让AI在明确边界内理解业务、生成SQL、解释结果。相比单一文本知识库、RAG向量召回或全量元数据召回,语义层有更明确的查询约束、可解释性、更低的推理消耗。

平台化之后,进一步解决口径过期、物理表更新、本地版本不一致、知识分散维护等问题——平台作为统一事实源,持续管理语义定义、版本、映射关系和消费治理。

演讲提纲:

1. 为什么需要语义平台

2. 本体和数据语义

3. 语义平台建设思路:语义挖掘、语义检索、本体、语义映射、测评体系、MCP、数据治理

4. 未来方向

听众收益:

· 如何基于数据仓库做数据语义平台建设

· 面向数据消费的数据语义建设方法

·Data Agent的落地路径

12|易车:从DataAgent到行动闭环,本体是三层底座之一

讲师:王林红 · 易车 · 数据平台负责人

演讲主题:从DataAgent到行动闭环的Agent决策执行实践

演讲介绍:企业数据从支撑人查数走向Agent决策执行,挑战不只是Text2SQL,而是口径、上下文、权限与行动风险。

易车从ChatBI、DataAgent演进到DataWork,建设覆盖可信数据、语义、本体和知识、MCP与 Harness的三层底座,并以查询进化和主动跟进打通分析、行动与结果验证,形成从可信问数、辅助分析到受控执行的企业数据智能演进路径。

王林红长期深耕大数据与AI领域,曾主导多家公司大数据平台、数据中台从0 到1 建设,现负责企业级AI Agent体系规划及落地,推动数据、语义、知识与执行能力平台化。

演讲提纲:

1. 从ChatBI到 DataWork:易车的实践历程

2. 从“会查数”到决策执行面临的挑战

3. 面向Agent-Ready的企业数据建设

4. 建设Agent原生底座:构建企业级Harness体系

5. 从工具提效到自主洞察:数据智能系统的能力进化

6. 未来规划

听众收益:

· 了解易车从ChatBI到 DataAgent的演进过程,以及在其中遇到的挑战

· 了解如何做好数据、知识和工具建设,让Agent找得到、看得懂、用得好企业数据

· 理解DataAgent不止于问数,Agent如何从回答问题走向主动发现、自主洞察和决策执行

03

前沿探索与跨行业延伸

13|中国人民大学:自进化数据智能体,Data–Ontology–Agent协同进化

讲师:张绍磊 · 中国人民大学信息学院 · 助理教授

演讲主题:自进化数据智能体:迈向Data–Ontology–Agent协同进化

演讲介绍:面向表格、数据库与文档等异构数据环境,现有数据智能体仍面临业务意图、数据语义与工具执行难以对齐的问题。传统固定工作流、检索增强和静态知识图谱,通常缺乏对开放任务与动态数据的持续适应能力。

张绍磊提出以Ontology作为可执行语义中间层的方法框架,统一建模领域概念、工具能力与数据模式,并基于智能体交互轨迹开展失败归因、知识修正和成对评测门控。

关键洞察是:数据智能体的典型错误并非来自模型幻觉,而是来自数据对象识别、字段语义映射和工具选择错误。

系统已稳定运行6 个月,注册用户超2000人、深度用户约400人,获得300余所高校和研究机构的试用申请。

张绍磊于中国科学院计算技术研究所获得博士学位,在NeurIPS、ACL、ICLR等会议发表论文30余篇,开源项目在GitHub累计10000+ 星标,曾任ACL ARR领域主席。

演讲提纲:

1. 业务与技术背景:数据智能体为何仍然“不理解数据”——Agent–Data Gap

2. 方案选型:为什么需要Ontology语义层(对比固定工作流、RAG、静态知识图谱)

3. 落地挑战:从静态Ontology走向自进化Ontology——冷启动、失败归因、避免能力回退

4. 解决思路:Data–Ontology–Agent协同进化

· 三层Ontology:Content Layer(业务概念/指标口径/实体关系)、Tool Layer(工具能力与约束)、Schema Layer(逻辑概念到物理表字段的映射)

· 交互轨迹失败归因 → 候选修改生成 → 持出验证集成对评测门控 → 版本化发布 / 拒绝回滚

· 形成“数据暴露问题 → 智能体产生轨迹 →Ontology沉淀知识 → 智能体再次验证”的持续进化闭环

5. 系统实践与阶段性成效

6. 未来规划:多智能体协同治理、与强化学习结合、多模态扩展、跨组织Ontology迁移

听众收益:

· 建立对Agent–Data Gap的系统认知,理解数据智能体的错误为何常发生在模型推理之前,并能区分模型、工具、数据和语义层问题

· 掌握可执行Ontology的设计方法:Content、Tool、Schema三层结构如何连接业务意图、工具操作与底层数据

· 获得一套可落地的自进化机制:交互轨迹归因、候选知识修改、成对评测门控、版本管理与安全回滚

14|某全球头部奢侈品厂商 × 数新智能:Apache Ossie本体规范与语义增强

讲师:谈总(某全球头部高端零售厂商 · 亚太大数据负责人)× 原攀峰(数新智能 ·CTO)

演讲主题:从多云底座到Agent-Ready:企业DataAgent架构升级与高端零售行业落地实践

演讲介绍:大模型正从单点Copilot演进为Agent智能范式,但企业的数据散落在多云多品牌之间,合规约束严苛,碎片化AI应用各自为战,Agent上了线也“无数据可用”。

这是一场双人分享,上下两篇:

· 上篇|业务视角:拆解高端零售全球化多云数据管理的真实痛点——数据孤岛、合规壁垒、碎片化AI的局限,以及对Agent-Ready数据底座的核心诉求

· 下篇|技术视角:多云AI原生平台之上的DataAgent整体架构、企业语义层构建、沙箱安全防护与闭环迭代体系

效果数据:端到端数据交付效率整体提升约70%;Agent任务诊断准确率提升50%;通过语义知识库建设,代码生成准确率从30% 提升到90%。

原攀峰为数新智能CTO,北航计算机硕士,前阿里巴巴集团大数据平台高级技术专家,阿里御膳房、阿里云数加、DataWorks创始团队核心领导,0-1完成阿里云隐私计算平台DataTrust产品研发及商业化落地,国内外发明专利20篇。

演讲提纲:

1. 上篇:高端零售全球化数智化转型背景与多云数据核心痛点

2. 上篇:行业AI+ 数据智能化实践——门店优化、用户运营、需求预测、防伪溯源

3. 上篇:业务侧对Agent-Ready数据底座的核心诉求

4. 下篇:数新一站式DataAgent整体架构设计——多云数智底座 + 企业专属语义层

5. 下篇:四大核心工程能力——Skills技能生态、上下文工程、沙箱安全防护、闭环迭代体系

6. 下篇:企业落地难点专项解法——多版本兼容容错、CodeWiki语义增强补齐业务知识库

7. 效果衡量与未来展望

听众收益:

· 业务视角:了解高端零售全球化企业多云数智转型的真实痛点,掌握Agent-Ready数据底座的建设门槛

· 技术视角:掌握Harness范式企业DataAgent完整架构设计,学习沙箱、细粒度权限管控等高合规行业安全落地策略

· 工程实践:学习Apache Ossie本体规范、CodeWiki语义增强方法论,补齐企业元数据短板,提升Agent业务理解与执行准确率

本体在中国落地,稀缺是有原因的。

它不只是一个技术选型问题,而是一连串必须提前做出的判断:概念层和实例层要不要分开?实例层建映射还是建对象库?口径冲突是强行统一还是保留差异?本体是一次性交付还是持续演进的基础设施?建完之后,怎么证明它比原来的方案更好?

这些问题没有标准答案,只有不同企业在各自约束条件下做出的取舍。

而真正有价值的,恰恰是这些取舍本身,以及它们背后的代价。

10月 23-24日,DACon 2026北京站。这14场演讲,是截至目前中国企业在本体落地上最密集的一次集体公开。

不管你是正在评估要不要上本体,还是已经上了但卡在“建完用不起来”,这里面大概率有一场,能帮你省下半年。

📅 时间:2026年 10月 23-24日

📍 地点:北京希尔顿逸林酒店

🔥本体落地企业集中亮相|参会报名火热进行中……DACon 2026北京站,15个分论坛,60+ 真实应用案例,2天沉浸式学习交流,现场还有闭门会和晚场圆桌。
注:文/龚作仁,文章来源:Laborer,本文为作者独立观点,不代表亿邦动力立场。


文章来源:Laborer

广告
微信
朋友圈

FAQ回顾

数据本体(Ontology)到底是什么?企业为什么要用它?

本体是组织企业知识的一种方式,把业务对象、属性、关系、指标和业务规则变成Agent可理解、可查询的语义结构。蚂蚁集团用它打通多源业务语义,理想汽车用它重新组织企业数据,让Agent从查数、分析走向销售决策,而不是简单按表取数。

企业落地本体为什么难?主要卡在哪些地方?

主要难点有五点:本体没有统一标准,Palantir、Snowflake、Databricks、Apache Ossie、Agent Memory五条路线差异明显;容易做成“大而全”,业务一变就臃肿失效;实现路径不可逆,建映射或对象库选错只能推倒重建;各业务线指标口径冲突难以协调;缺少持续迭代机制,建完就贬值。

各业务线对同一指标口径不一致,怎么解决?

蚂蚁集团的做法是不强行统一口径,而是让本体保留差异,由Agent按需取用。其底层用LangGraph六节点状态机完成本体合成与校验,Reconciler对跨表同名字段做7层级成本递进消融,核心原则是冲突标记但不强制合并,从而兼顾多业务线语义和业务理解。

高端零售或奢侈品企业的多云数据底座改造能带来哪些效果?

一家全球头部奢侈品厂商与数新智能合作,基于Apache Ossie本体规范和CodeWiki语义增强建设Agent-Ready数据底座,端到端数据交付效率整体提升约70%,Agent任务诊断准确率提升50%,代码生成准确率从30%提升到90%。

企业如何选择本体技术路线?语义映射和对象库怎么取舍?

本体当前没有统一标准,选型要先看知识怎么表示、运行、生产和验证。天翼支付给出的实例层判断依据是四条:查询形态、时延要求、是否需要状态与回写、变更频率;方案可取核心对象物化、长尾保留映射的混合方案,边界要提前写死,避免不可逆返工。

这么好看,分享一下?

朋友圈 分享

APP内打开

赞 +1
+1
微信好友 朋友圈 新浪微博 QQ空间
关闭
收藏成功
发送
/140 0